一句结论
河南三支一扶这场省级统一考试,被一群职业作弊团伙从命题环节开始就精准击穿。14.1 万名考生陪着作弊者走完了从笔试到面试资格确认的整段路,直到有人用 Excel 拉了一遍成绩分布,整件事才被撕开口子。
这不是"抓出几个作弊的"就完事的事——整场考试成绩全部作废,8月22日重考,才是唯一合理的收场。
一、分数自己露出了马脚
7月24日成绩公布后,网友做了一件普通考试后很少有人做的事:把安阳、济源、平顶山、驻马店等地的面试资格确认名单拉进表格,横向比较。
出来的图异常干净:
| 岗位计划人数 | 80分以上人数 |
|---|---|
| 招 1 人 | 1 人 80+ |
| 招 2 人 | 2 人 80+ |
| 招 4 人 | 4 人 80+ |
第一名 80 多分,第二名直接跌到 60 多分。分数分布"精准匹配"名额,主打一个不浪费。
更有 3 名考生同时报了济源的乡村振兴协理员和三支一扶两场考试,相隔 13 天,分数从 50 多分暴涨到 80 多分。
二、用数学说话
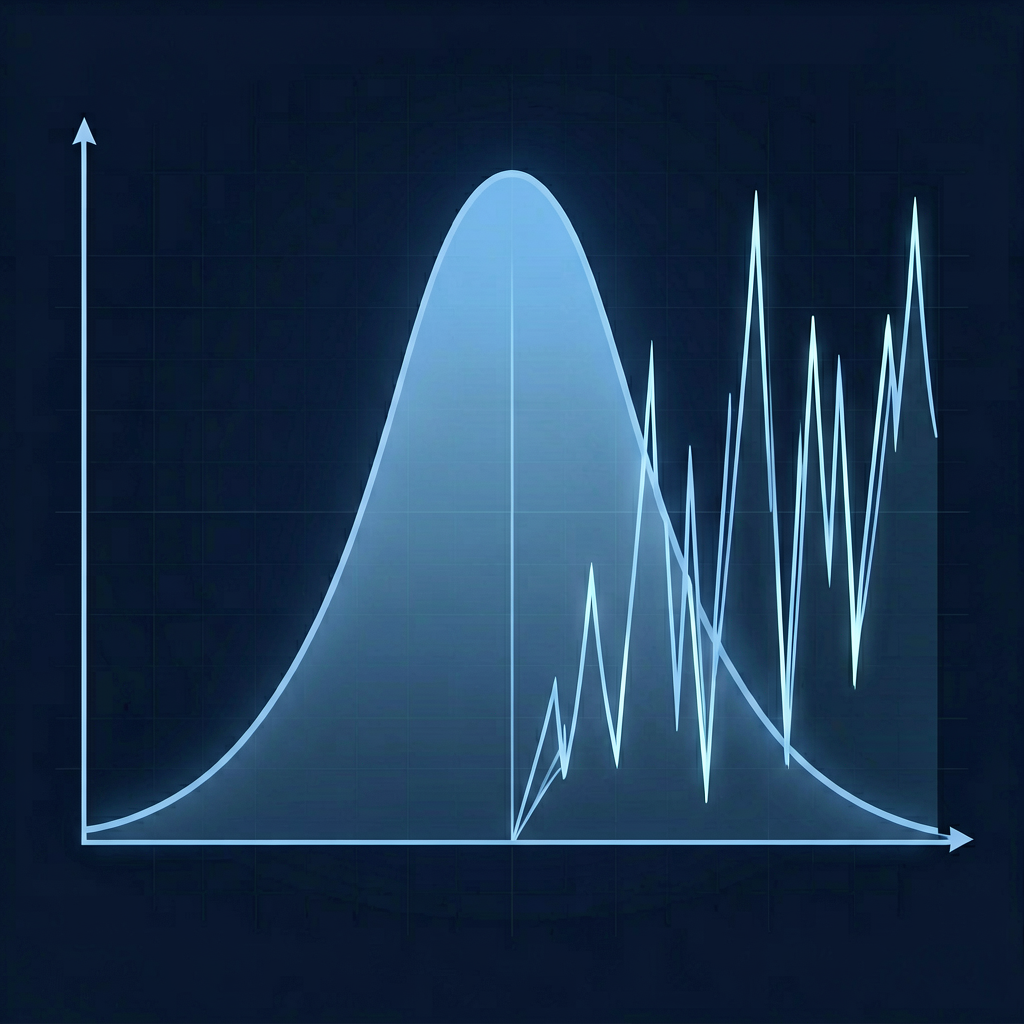
一场正常的选拔考试,分数分布近似正态分布——中间高、两头低,大部分考生挤在均值附近,80 分以上和不及格都是少数。
今年河南三支一扶笔试刚引入了严格的不定项选择题:多选、错选、少选均不得分,无保底分,整体难度大幅提升。连考生自己都感叹"能考到 60 分已属不易"。在这种题目难度下,80 分以上扎堆出现、人数刚好等于岗位名额,概率低到什么程度?
用简单的二项分布估算:假设一个岗位报名 50 人,每个人自然考到 80+ 的概率按 5% 算,50 人里恰好 k 人 80+ 服从二项分布 $B(50, 0.05)$。现实里,每个岗位的 80+ 人数都刚好等于招募名额——这种"精准控分",不是运气能解释的。
三、官方是怎么回应的
从曝光到定性,仅用了不到 10 天:
| 时间 | 事件 |
|---|---|
| 7月27日 | 省协调办公室发首个声明,成立工作组 |
| 7月28日 | 要求未公布笔试成绩的地市 7月30日前补齐;“查实一个取消一个” |
| 8月2日 | 通报发现作弊行为,省人事考试中心负责人停职,公安成立专案组 |
| 8月7日 | 公告 7月11日成绩全部作废,8月22日重考 |
8月2日深夜的通报是关键转折点——“河南省人事考试中心负责人被停职调查”。如果只是个别考生夹带小抄,停的是监考老师就够了。停省人事考试中心负责人,说明作弊链条已经上探到命题、印卷、保管环节。
公安专案组后来查明的模式是:考前勾结考务人员获取试卷 → 场外组织人员答题 → 电子设备"点对点"向付费考生传递答案。河南人事考试中心的解释戳到了核心痛点:“除高分作弊者外,无法确定考 60 多、70 多分的考生是否也作弊或故意控分。”
四、为什么不能只取消作弊者成绩
很多考生问:抓出作弊的,凭什么让 14.1 万人陪跑?
因为试卷在开考前已经不是秘密了。没作弊的考生和作弊的考生从一开始就不在同一赛道——一道分数筛选的防线,连同它背后可比性的基础,一起作废了。
更关键的是"控分"。职业团伙不会让所有作弊者都考出极端高分,他们会按岗位报名情况布置分数,让 60 分、70 分的成绩看起来"自然"。这意味着即使筛掉 80 分断层的那一批,名单里仍可能藏着精准控分的作弊者。
所以不是"陪跑",是整场考试失去了作为选拔依据的资格。14.1 万人要重考是代价,但比让作弊者带着假成绩进基层的代价小得多。
五、历史并非空白
这类事件不是第一次:
| 年份 | 事件 | 结果 |
|---|---|---|
| 2014 江西九江 | 28 人试卷异常雷同 | 成绩作废,部分承认使用接收器 |
| 2023 重庆丰都 | 事业单位招聘多名考生 140 多分断崖领先 | 查实作弊,成绩取消,移交公安 |
| 2026 河南 | 三支一扶分数精准匹配名额 | 成绩全部作废,重考,公安专案组 |
模式在升级。从"夹带小抄"到"试卷雷同",再到"考前拿到卷 + 点对点传递",作弊已经从个人投机演变成了内外勾结的产业化犯罪。三支一扶服务期满后在公务员定向招录、事业单位招聘、考研加分上有政策倾斜,对应届生吸引力很高——2026 年河南 3082 个岗位,14.1 万人报名,百里挑二。市场足够大,黑产自然跟进。
六、建设性建议:怎么让下次别再作废
这场考试作废,代价是 14.1 万人的时间成本 + 财政保障的补助(省外 300 元/人、省内 200 元/人)。要避免重演,光靠事后抓人不够,要在流程上把作弊者的操作空间压缩到接近零。
1. 分级命题 + 现场启封。 省级统考命题不应只有一份母卷,应按考点或考场生成多套平行卷。试卷在考点现场启封,切断考前流通的可能。这是最基础也最有效的防线。
2. 信号屏蔽从"考场"扩到"考点"。 电子设备"点对点"传递,说明信号屏蔽只封住了考场,没封住考务区、印卷室、走廊。信号监测车 + 入场金属探测 + 考务人员电子设备集中封存,三层叠加。
3. 成绩发布强制配套统计画像。 面试资格确认名单发布时,强制同步公布每个岗位的成绩分布直方图 + 均值/中位数/标准差。让"正态分布异常"在数据层面就被公众和媒体一眼识别,不需要等网友自己做 Excel。
4. 关键岗位跨区交叉监考。 命题人、印卷人、监考官、阅卷人之间建立物理隔离和角色轮换,切断"自己命题自己考自己阅卷"的闭环。
5. 把"控分识别"写进规程。 官方通报里那句"无法确定 60 多、70 分是否也作弊",说明现有规程只盯极端高分,忽略了精准控分。应建立分数分布偏离度的自动预警机制,触发即启动阅卷录像 + 考场监控复盘。
公平不是一句口号,是分数分布图上那个该隆起的中间段。当中间段塌了、只剩几颗精准分布的尖峰时,整张图就该作废。
这场 14.1 万人的重考,代价沉痛,但值得。因为它给所有省级统考上了一课:在命题、传递、阅卷全链路数字化之前,只要有一个环节是人情社会,公平就永远差一步。
有意思的是,这种"制度失守"的反思,和中国 AI 治理的处境有点呼应——斯坦福 HAI 2026 报告显示中美模型差距已收窄到 2.7%,但资本投入仍差 23:1;中国在 AI 论文、专利上双居全球第一,工业机器人保有量是美国的 9 倍。技术上我们追得快,制度治理上却还差半步:AI 训练数据的版权合规、大模型幻觉的责任归属、生成式内容的溯源——这些"看不见的手"和考试作弊一样,都需要在规则层面把漏洞堵死。技术追赶靠投入,公平守护靠流程,两者都不能只靠"事后抓人"。
如果觉得有帮助,点个「赞」和「在看」支持一下 👇